MiM8期 A班学员
迟 鼎 知
北京兴源诚经贸发展有限公司 会计
作为一名在财务领域工作多年的从业者,我对数据的理解曾经长期停留在“报表”层面。会看利润表、读得懂现金流量,也习惯了用Excel做几张透视表。但坦白讲,过去我用数据的方式,更像是“确认过去发生了什么”,而非“预判未来可能发生什么”。
随着公司在数字化转型上的投入越来越大,业务部门开始频繁提起“用户画像”“精准营销”“智能风控”这些词。同事们讨论着模型、算法、特征工程,而我听着这些概念,心里很清楚:如果再不补齐数据挖掘这一课,自己很快就会被行业的下一波浪潮甩下。带着这种焦虑和求知欲,我走进了上国会-凯瑞会计(数据分析)MiM项目沙溪清教授的《数据挖掘》课堂。
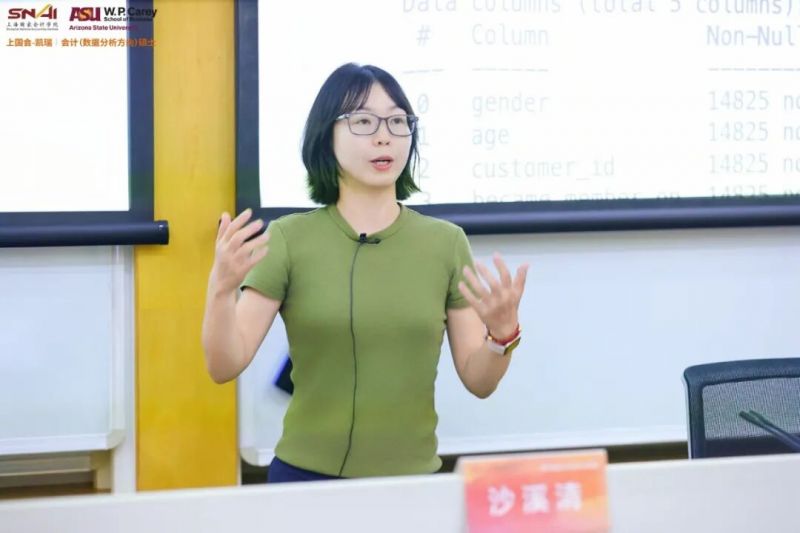
沙溪清教授是美国亚利桑那州立大学W.P.凯瑞商学院信息系统系的实践副教授,深耕机器学习、深度学习和AI应用领域多年。她不仅是商业数据分析本科项目委员会主席,还获得过多项教学荣誉。四天的课程从数据挖掘基础到分类、回归、聚类、神经网络逐层展开,每天上午理论+下午Python实操的节奏虽然密集,但每学完一个模块,都让人有一种“原来如此”的通透感。
从CRISP-DM到星巴克:数据挖掘
不是玄学,而是一套可复用的解题框架
课程开篇,沙教授就用一张清晰的层级图厘清了“数据挖掘—机器学习—深度学习—人工智能”这四个被反复混用的概念:数据挖掘是在数据中发现模式、支持决策;机器学习让机器从数据中学习并作出预测;深度学习是多层神经网络处理复杂数据;人工智能是最广泛的概念,旨在使机器模拟人类智能。
她用医疗场景做类比,数据挖掘是分析历年疾病发病率的高风险区域;机器学习是根据病人体检数据预测患病概率;深度学习是分析CT影像自动标注癌症位置;AI是整合所有能力给出诊断建议的健康助手。四句话就把概念边界勾勒得清清楚楚。
真正让我感到“实用”的,是贯穿全课的方法论主线——CRISP-DM流程。这个跨行业数据挖掘标准流程包含六个环节:业务理解、数据理解、数据处理、建模、评估、部署。沙教授用了星巴克面对中国咖啡市场竞争的真实案例来串联讲解:从管理层发现部分会员消费频率下降、营销转化效果有限开始(业务理解),到梳理已有的会员消费记录、App使用行为、优惠券使用情况等数据(数据理解),再到缺失值处理、特征工程(数据处理),然后选择逻辑回归、决策树或XGBoost建模,用ROC/AUC指标评估模型效果,最后将模型部署至CRM系统生成客户忠诚分数、投放个性化优惠。
这套流程的价值在于它清晰地回答了“数据挖掘项目到底从哪里下手”,这是最基础、也是最致命的问题。过去我对数据项目的认知是碎片化的,知道一些算法名词,但不清楚它们在整个商业决策链条中的位置。CRISP-DM把从商业问题到技术落地之间的每一步都打通了,这让我回到工作岗位后,面对一个具体业务问题时,脑子里终于有了一张可以按图索骥的地图。
从决策树到深度学习:算法是
工具,但理解它的“为什么”才是关键
课程涉及了大量算法,但沙教授的教学风格让我印象极深。她从不让学生死记硬背公式,而是先讲“为什么需要这个算法”和“它背后的直觉是什么”。
比如讲决策树,她没有一上来就堆砌信息增益的数学推导,而是先用一组简笔画小人做例子。头型是方的还是圆的、体型是长方形还是椭圆、身体是黑的还是白的。一步步手动演示决策树如何递归地选择最优属性进行划分,直到每个叶节点尽可能纯净。在这种形象化的铺垫之后,再引入熵和信息增益的计算,就变得水到渠成。她还特意强调了过拟合的陷阱:一棵深度太大、节点太多的决策树可能在训练集上表现完美,但一遇到新数据就原形毕露——复杂度控制和泛化能力之间的平衡,是贯穿所有模型的核心痛点。
讲逻辑回归时,她花了相当篇幅解释为什么要用Sigmoid函数把线性输出“压缩”到0和1之间。因为概率本来就不能超过1,这种追根溯源的讲解方式,让我第一次真正理解了这些经典算法不是从天而降的“黑箱”,而是有明确数学直觉支撑的工具。
第四天的神经网络与深度学习模块,是我最期待、也最担心听不懂的部分。出人意料的是,沙教授从生物神经元的工作原理讲起。树突接收信号、权重反映重要程度、细胞体求和、超过阈值就触发。课堂里她用“教授讲课、学生听音乐、手机通知弹出、内心杂念干扰”做类比,把抽象的人工神经元模型讲得像在描述真实的课堂场景。
随后层层推进,从单层感知机到多层神经网络,再到CNN卷积网络在图像识别和自动驾驶中的应用,以及语义情感分析如何用于审计报告风险识别和财经新闻情绪判断。前者尤其让我这个财务人眼前一亮:模型分析“Material weaknesses were identified in internal controls”这类审计措辞时,能自动将其标记为负面信号,这种NLP技术在审计实务中的落地可能,让我看到了数据挖掘与财务专业的交叉点。
从聚类到关联规则:
无监督学习的商业想象力
如果说有监督学习的分类和回归,还能和传统统计找到一些衔接点,那么无监督学习板块,对我而言就是全新的认知拓展。
沙教授在讲解聚类分析时,设计了一个非常接地气的例子。如何用欧几里得距离,在所有白酒中找到与茅台风格最相似的替代品。她把每款白酒量化为一个包含香气浓度、酱香风味、口感醇厚度、酒精度、价格、回味长度等十个维度的特征向量。然后用距离计算排序,得出“青花郎”是与茅台最相似的结论。这个案例让我豁然开朗:原来看似主观的“口感相似”这种东西,完全可以用数学语言精准地描述和比较。
关联规则分析中的支持度、置信度、提升度三个指标,则让我看到了数据挖掘在采购风控上的潜力。沙教授举的例子是,如果财务部门发现某些采购项目,频繁以非正常的组合出现在报销单中,其提升度远高于随机预期水平,就可能暗示违规采购或虚假报销。这正是将数据挖掘从“洞察过去”推向“预警未来”的生动体现。
四天的课程结束,我最大的感受不是“学了四个新算法”,而是对整个数据挖掘的认知框架被重构了。以前我看数据是平面的,现在学会了用不同算法从多个角度透视同一批数据;以前我觉得数据挖掘是技术部门的事,现在理解了它本质上是一种“商业翻译”——把业务问题翻译为数据问题,再用算法求解,最后把结果翻译回业务语言。
正如沙教授在课堂上反复强调的,数据挖掘不是目的,而是连接“数据”与“决策”之间的桥梁。对企业而言,数据积累得再多,如果没有将数据转化为洞察力的能力,也不过是一座尚未开采的矿藏。而这门课教给我们的,正是一把挖矿的镐。
MiM8期 A班学员
邓 峰
中铁山桥集团有限公司 总会计师、总法律顾问
解锁财务“数据密码”
沙溪清教授打造4天全链路实战特训,完整覆盖数据清洗至预测建模全流程实操,针对性化解财务信息杂乱等痛点,实现经营规律量化分析、风险精准识别、客户成本智能分群。课程结合Capital One信贷优化、沃尔玛库存预测标杆案例,教大家盘活企业沉睡数据资产,将零散数据转化为高效智能决策引擎,吃透财务数智化转型核心逻辑。
从“账房先生”到“价值中枢”
智能算法全面重构财务职能,预测模型赋予财务前瞻研判能力,聚类分析落地精细化成本管控,全域数据互通打通业财信息壁垒。算法并非取代财务积淀的专业经验,而是依托数据洞察放大专业判断,推动财务部门转型为业务价值创造核心,完成财务岗位的战略层级跃升。
数智时代的财务觉醒
数字化工具仅是落地载体,数据思维才是转型内核。财务数智化的本质是人机协同,财务人员需跳出基础核算执行工作,转变为企业价值挖掘者。以数据为抓手打破传统财务工作边界,工作重心从记录经营价值转向主动创造业务价值,引领企业财务体系变革。如今数智浪潮奔涌而至,唯有掌握数据技术、建立数据思维,才能站稳行业前沿,重塑财务发展新未来。
>>>>>>>>>>>>>>>>>>>><<<<<<<<<<<<<<<<<<<<
《数据挖掘》课程
沙溪清 亚利桑那州立大学信息系副教授
本课程从数据挖掘的基本概念出发,系统讲解常用的算法与模型,并通过Python等主流开源工具,演示如何在实际商业环境中应用这些技术。课程旨在培养学生将数据转化为洞察力与决策能力的实践能力,为未来在数据驱动型行业中的发展打下坚实基础。